15강 / 20강
성능 지표 읽기 — 어디서 기다리고 있나
load average · %us %sy %wa %si · vmstat 로 병목 찍기
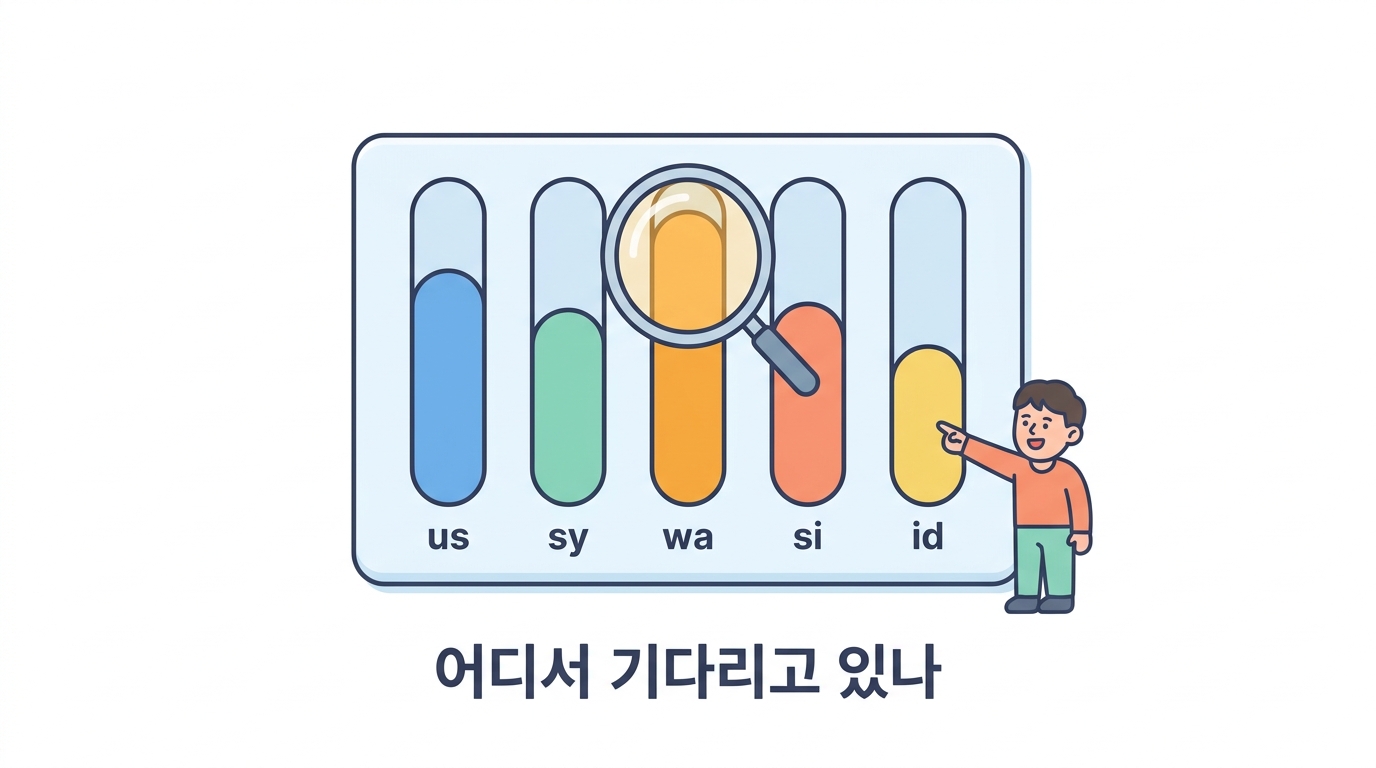
사장님이 전화합니다. "쇼핑몰이 느려요."
여러분은 SSH로 접속합니다. 그리고 3분 안에 원인이 CPU인지, 메모리인지, 디스크인지, 네트워크인지 찍어야 합니다. 그 방법을 배웁니다.
① load average — 줄 서 있는 사람 수
uptime이 보여 주는 세 숫자는 1분·5분·15분 평균입니다.
"CPU 사용률"이 아니라 일하려고 기다리는 프로세스 수예요.
리눅스에서는 디스크를 기다리는 프로세스도 여기 포함됩니다.
load 를 CPU 수로 나눈 값이 진짜 지표입니다.
bash
브라우저에서 실행
load는 반드시 코어 수로 나눠서 읽습니다.
Python
브라우저에서 실행
② CPU 시간의 다섯 조각 — 여기가 핵심입니다
top의 %Cpu(s) 줄이 병목 진단의 가장 강력한 도구입니다.
| 칸 | 뜻 | 높으면 무슨 뜻인가 |
|---|---|---|
us | 사용자 코드 실행 | 내 앱이 계산 중. 정상적인 바쁨. 코드나 코어를 봐야 함 |
sy | 커널 실행 | 시스템 콜·문맥 교환이 과하다. 워커/스레드가 너무 많은가? |
wa | 디스크를 기다리는 시간 | 디스크 병목. CPU는 놀고 있다 |
si | 소프트 인터럽트 | 네트워크 패킷 폭주. 13강 참고 |
id | 놀고 있음 | 여기가 크면 CPU는 병목이 아니다 |
지금 이 서버의 CPU 시간 분포입니다.
bash
브라우저에서 실행
③ vmstat — 한 화면에 다 있다
vmstat 1은 관리자가 가장 많이 쓰는 명령입니다.
첫 줄은 부팅 후 평균이라 버리고, 두 번째 줄부터 읽어요.
r · b · si · so · wa 다섯 칸만 봐도 됩니다.
bash
브라우저에서 실행
읽는 순서는 이렇습니다.
si/so가 0인가? — 아니면 즉시 메모리 문제. 여기서 끝b가 0인가? — 아니면 디스크를 기다리는 프로세스가 있다wa를 본다 — 높으면 디스크 병목r을 코어 수와 비교 —r> 코어 수면 CPU에 줄이 섰다cs가 비정상적으로 큰가 — 문맥 교환 과다
직접 장애를 만들어 봅시다
stress-ng로 서버에 일부러 부하를 걸고, 지표가 어떻게 변하는지 확인합니다.
us 가 90%대로 올라갑니다. wa 는 그대로예요.
bash
브라우저에서 실행
이번엔 wa 가 올라갑니다. 같은 '느림'인데 원인이 다릅니다.
bash
브라우저에서 실행
④ 어느 프로세스가 범인인가
%CPU 와 RES 를 함께 봅니다.
bash
브라우저에서 실행
⑤ 진단 순서 요약
1. uptime          → load / 코어수 로 심각도 파악
2. vmstat 1 5      → si/so 로 메모리 문제부터 배제
3. top             → us / sy / wa / si 로 병목 종류 결정
4. iostat -x       → wa 가 높으면 어느 디스크인지
5. ps aux --sort=-%cpu | head → 범인 프로세스 특정
6. 로그 확인       → 언제부터, 무엇 때문에
이 한 줄이면 대부분의 상황을 판별할 수 있습니다.
bash
브라우저에서 실행
🤔 확인 문제
쇼핑몰이 느려서
top을 봤더니 %Cpu(s): 6.0 us, 4.0 sy, 8.0 id, 81.0 wa 입니다. 무엇이 병목인가요?해설
wa는 CPU가 일한 시간이 아니라 기다린 시간입니다. 실제로 계산에 쓴 건 us+sy = 10%뿐이에요. CPU를 늘리면 기다리는 CPU가 늘어날 뿐입니다. iostat -x로 어느 디스크인지 찾고, 18강의 방법으로 대응해야 합니다.🤔 확인 문제
논리 CPU 12개짜리 서버의 load average가
3.20, 8.50, 14.10 입니다. 지금 상황은?해설 1분(3.2) < 5분(8.5) < 15분(14.1) — 시간이 갈수록 줄고 있습니다. 15분 전엔 14.1/12 = 1.2로 줄이 섰지만 지금은 0.27로 여유롭죠. 이미 지나간 일이니, 원인을 로그에서 찾아 재발을 막는 게 다음 할 일입니다.