13강 / 20강
버스와 입출력 — CPU가 기다리지 않는 법
PCIe · 인터럽트 · DMA, 그리고 네트워크 카드
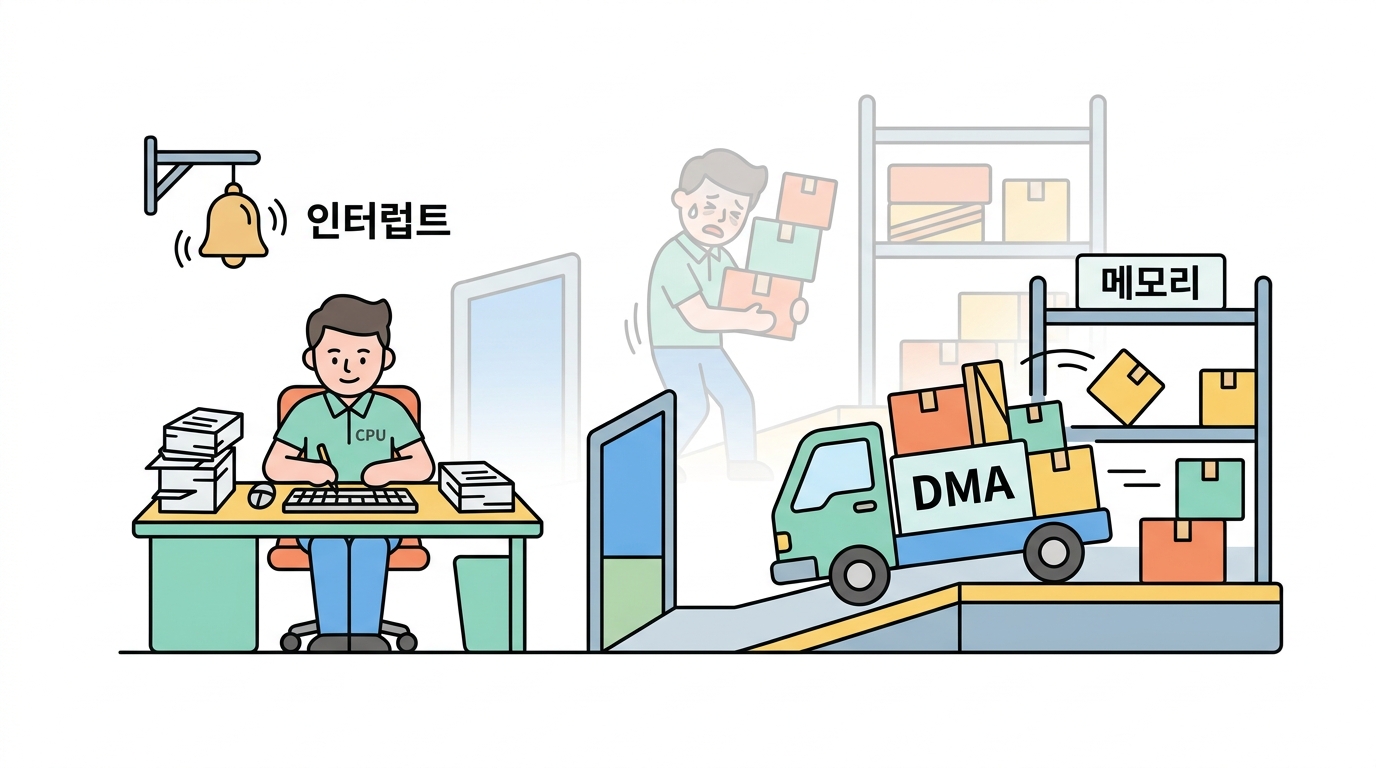
지금까지 CPU·메모리·디스크를 봤습니다. 그런데 이들이 어떻게 서로 이야기할까요?
그리고 더 중요한 질문 — 디스크에서 1MB를 읽어 오는 동안(0.15ms 정도) CPU는 무엇을 하고 있을까요? 멍하니 기다린다면 엄청난 낭비입니다.
버스 — 부품들을 잇는 고속도로
요즘 서버의 주된 통로는 PCIe입니다. 차선 수(x1, x4, x16)와 세대(Gen3, Gen4, Gen5)로 속도가 정해져요.
PCIe 차선 수 × 세대 = 대역폭.
Python
브라우저에서 실행
NVMe는 01:00.0, 랜카드는 02:00.0과 03:00.0에 있습니다.
bash
브라우저에서 실행
CPU가 기다리지 않는 세 가지 방법
인터럽트 — 손 들고 부르기
디스크가 데이터를 다 준비하면 CPU에게 전기 신호로 손을 듭니다. CPU는 하던 일을 잠깐 저장해 두고, 정해진 처리 함수로 뛰어갔다가 돌아와요.
이 "잠깐 저장하고 뛰어갔다 오기"가 공짜가 아닙니다. 문맥 교환이 일어나거든요 — 레지스터를 전부 저장하고, 캐시가 밀려나고, TLB가 무효화됩니다.
in = 인터럽트, cs = 문맥 교환. 요청이 많아지면 함께 올라갑니다.
bash
브라우저에서 실행
DMA — CPU를 아예 빼는 방법
인터럽트로 "다 됐다"는 걸 알아도, 데이터를 장치에서 메모리로 옮기는 일은 남습니다. 1MB를 CPU가 4바이트씩 옮기면 26만 번의 복사예요. 미친 짓이죠.
그래서 장치가 직접 메모리에 씁니다. 이게 DMA입니다. CPU는 "여기부터 여기까지 채워 놔"라고 시켜 놓고 다른 일을 하다가, 다 됐다는 인터럽트만 한 번 받으면 끝이에요.
DMA가 없으면 서버가 파일 하나 보내다 멈춥니다.
Python
브라우저에서 실행
네트워크 카드도 병목이 됩니다
회선이 병목일 때는 CPU를 늘려도 소용없습니다.
Python
브라우저에서 실행
🤔 확인 문제
nginx가 이미지 파일을 보낼 때 CPU를 거의 쓰지 않는 이유는?
해설 복사를 CPU가 하지 않는 것(zero-copy)이 핵심입니다. C로 짜여 있는 것도 도움이 되지만, 진짜 이유는 DMA가 대신 나르기 때문이에요. 그래서 정적 파일은 앱 서버가 아니라 nginx나 CDN이 뿌리게 합니다.
🤔 확인 문제
트래픽이 폭증하자
top의 %si(soft interrupt)가 40%까지 올라갔습니다. 무엇을 의심해야 하나요?해설 %si는 주로 네트워크 패킷 처리에서 옵니다. 인터럽트 병합 설정, RSS(여러 코어로 인터럽트 분산), 또는 앞단에 CDN·로드밸런서를 두는 것이 대응입니다. 앱 코드를 최적화해도 이건 안 줄어들어요.