8강 / 20강
캐시 — 순서만 바꿔도 10배
캐시 라인 64바이트가 만드는 성능 차이
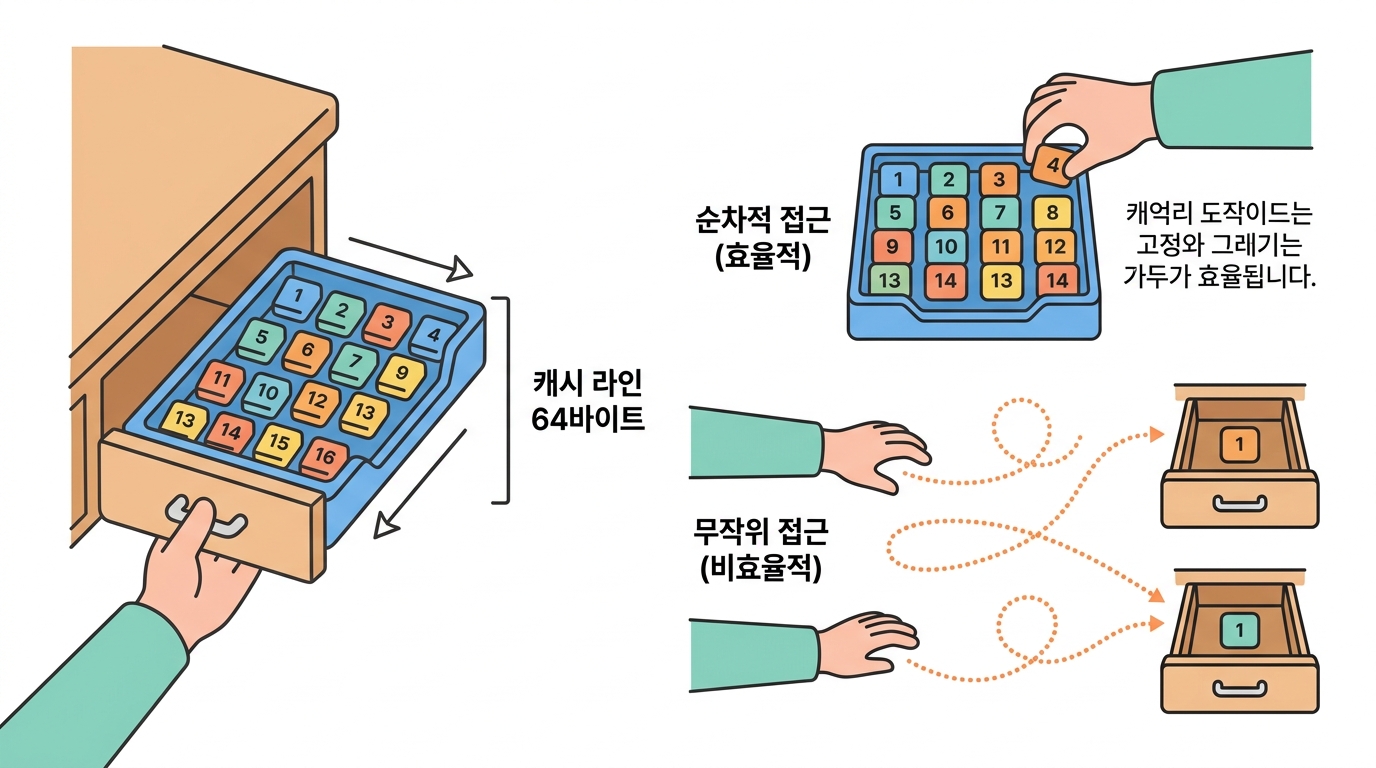
같은 개수의 숫자를 더하는 두 프로그램이 있습니다. 하나는 순서대로 훑고, 하나는 띄엄띄엄 훑습니다. 계산량은 똑같아요. 그런데 속도는 10배가 차이 납니다.
왜일까요? 캐시 라인 때문입니다.
캐시 라인 — 항상 64바이트씩
CPU가 메모리에서 정수 하나(4바이트)를 부탁하면, 메모리 컨트롤러는 그 주변 64바이트를 통째로 실어 옵니다. 트럭이 한 번 가는데 짐 하나만 싣고 올 이유가 없거든요.
필요한 것:  [■]
실제로 오는 것: [■][ ][ ][ ][ ][ ][ ][ ]  ← 64바이트 = 정수 16개
그래서 다음에 옆 칸을 읽으면 공짜입니다. 이미 캐시에 와 있으니까요. 반대로 다음에 100칸 떨어진 곳을 읽으면 또 다녀와야 합니다.
간격을 늘리면 일은 줄어드는데 개당 비용은 올라갑니다.
Python
브라우저에서 실행
실무에서 이게 나오는 곳 — 2차원 배열
파이썬 리스트든 C 배열이든 넘파이 행렬이든, 2차원 데이터는 메모리에 한 줄로 펴져 있습니다. 그래서 행 우선으로 훑느냐 열 우선으로 훑느냐가 캐시 히트율을 가릅니다.
같은 계산, 다른 순서, 다른 속도.
Python
브라우저에서 실행
진짜 CPU의 캐시 미스를 세어 봅시다
리눅스의 perf 는 CPU 안에 있는 하드웨어 계수기를 읽습니다.
캐시 미스가 몇 번 났는지, IPC가 얼마인지를 실제로 세어 줘요.
cache-misses 비율과 IPC를 봅니다.
bash
브라우저에서 실행
보통 이렇게 읽습니다.
- IPC 2 이상 — 아주 좋음. CPU가 쉬지 않고 일하는 중
- IPC 1 안팎 — 보통
- IPC 0.5 미만 — CPU가 뭔가를 기다리고 있다. 대개 메모리
- cache-miss 10% 이상 — 데이터 접근 패턴을 의심할 때
캐시가 여러 개일 때 — 코어끼리 싸운다
이 서버는 6코어입니다. L1·L2는 코어마다 하나씩, L3는 여섯이 나눠 씁니다.
L1/L2는 짝꿍 스레드끼리, L3는 전체가 나눠 씁니다.
bash
브라우저에서 실행
🤔 확인 문제
정수 배열을
a[0], a[1], a[2]… 순서로 읽는 것이 a[0], a[1000], a[2000]… 보다 훨씬 빠른 이유는?해설 캐시 라인 하나(64바이트)에 4바이트 정수 16개가 들어갑니다. 순서대로 읽으면 16번에 한 번만 메모리에 다녀오면 되지만, 1000칸씩 뛰면 매번 다녀와야 해요.
🤔 확인 문제
perf stat 결과가 IPC 0.3, cache-misses 22% 로 나왔습니다. 무엇을 의심해야 할까요?해설 IPC가 1보다 한참 낮다는 건 클럭은 도는데 명령을 못 내보내고 있다는 뜻입니다. 캐시 미스가 22%라면 원인이 뚜렷해요 — CPU를 더 좋은 걸로 바꿔도 소용없고, 데이터를 모아서 순서대로 읽도록 고쳐야 합니다.