7강 / 20강
메모리 계층 — 가까울수록 작고 비싸다
레지스터에서 서울-런던까지, 기다림의 지도
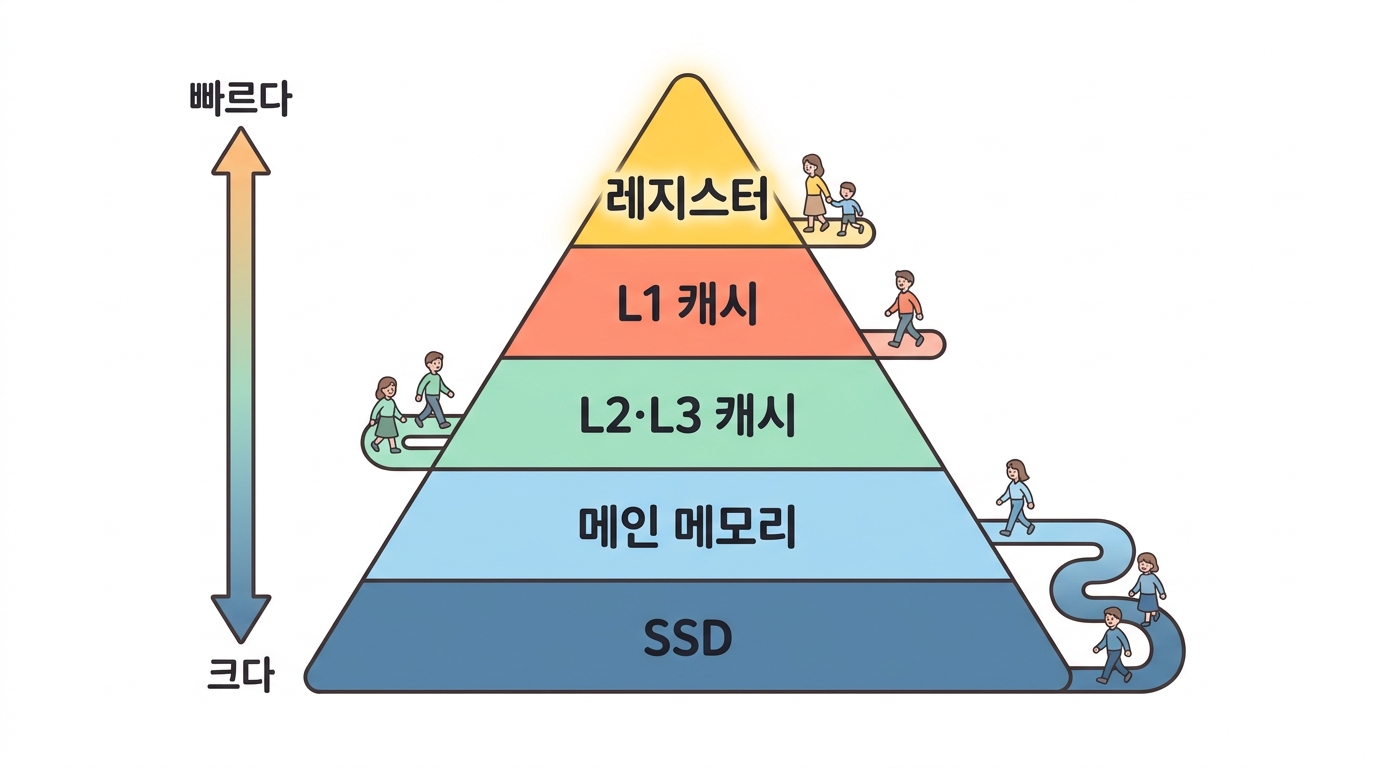
CPU가 값 하나를 가져오는 데 걸리는 시간은 그 값이 어디 있느냐에 따라 어마어마하게 달라집니다. 얼마나 달라지는지 감이 잘 안 오죠?
그래서 1나노초를 1초로 늘려 사람의 시간으로 바꿔 보겠습니다.
나노초를 초로 늘리면 감이 옵니다.
Python
브라우저에서 실행
왜 그냥 전부 빠른 걸로 만들지 않을까
답은 셋입니다 — 돈, 크기, 물리 법칙.
| 계층 | 크기 | 1GB당 값(대략) | 왜 이 크기인가 |
|---|---|---|---|
| 레지스터 | 수백 바이트 | — | ALU 옆에 붙어야 해서 |
| L1 캐시 | 48KB/코어 | 수천만 원 | 1클럭 안에 닿아야 해서 |
| L3 캐시 | 12MB | 수백만 원 | 칩 면적을 차지해서 |
| DRAM | 16GB | 약 5,000원 | 칩 밖이라 신호가 멀다 |
| NVMe SSD | 512GB | 약 200원 | 전원이 꺼져도 남아야 해서 |
L1을 16GB로 만들면? 칩이 자동차만 해지고, 신호가 한쪽 끝에서 다른 끝까지 가는 데 클럭 수백 개가 걸려서 결국 느려집니다. 크면 느릴 수밖에 없어요.
그럼 왜 이 계층이 실제로 잘 먹힐까 — 지역성
층층이 쌓아 놓고 "자주 쓰는 건 위층에" 두는 전략이 통하는 이유는 프로그램이 메모리를 제멋대로 쓰지 않기 때문입니다.
이 두 습관 덕분에, 아주 작은 캐시로도 95% 이상을 잡아낼 수 있습니다.
히트율 9%p 하락 = 4배 느려짐.
Python
브라우저에서 실행
내 서버의 계층을 확인해 봅시다
이 서버의 캐시 크기와 캐시 라인 크기입니다.
bash
브라우저에서 실행
coherency_line_size가 64죠. 이게 캐시 라인입니다 —
CPU가 메모리에서 뭔가를 가져올 때 항상 64바이트씩 통째로 가져온다는 뜻이에요.
1바이트만 필요해도 64바이트를 들고 옵니다.
왜 그럴까요? 공간 지역성 때문입니다. 어차피 옆 것도 곧 쓸 테니까. 다음 강에서 이 64바이트가 성능을 어떻게 가르는지 직접 재 봅니다.
-T 는 디스크가 아니라 캐시를 잰 값입니다. 차이를 보세요.
bash
브라우저에서 실행
🤔 확인 문제
서버가 스왑을 쓰기 시작하면 응답이 수십 배 느려집니다. 메모리 계층으로 설명하면?
해설 약 1000배 먼 곳으로 심부름을 보내는 셈입니다. 16강에서 실제로 스왑에 빠진 서버의
vmstat 을 읽어 봅니다 — si/so 칸에 숫자가 찍히면 그게 신호예요.🤔 확인 문제
캐시가 작은데도 잘 먹히는 이유는?
해설 시간 지역성(방금 쓴 걸 또 쓴다)과 공간 지역성(옆을 쓴다)입니다. 이 습관이 없는 프로그램 — 예를 들어 거대한 배열을 무작위 순서로 훑는 코드 — 은 캐시가 아무리 커도 소용이 없어요.