17강 / 20강
워커를 몇 개 띄울까 — CPU 튜닝
문맥 교환 · 처리량 곡선 · cgroup 제한
gunicorn 설정 파일에 이렇게 적혀 있습니다.
gunicorn -w 3 -b 127.0.0.1:5000 shop:app
-w 3, 워커 3개. 이 숫자는 어떻게 정해야 할까요?
인터넷에는 (2 × 코어) + 1 이라고 나와 있지만, 왜 그럴까요?
그리고 그게 여러분 쇼핑몰에도 맞을까요?
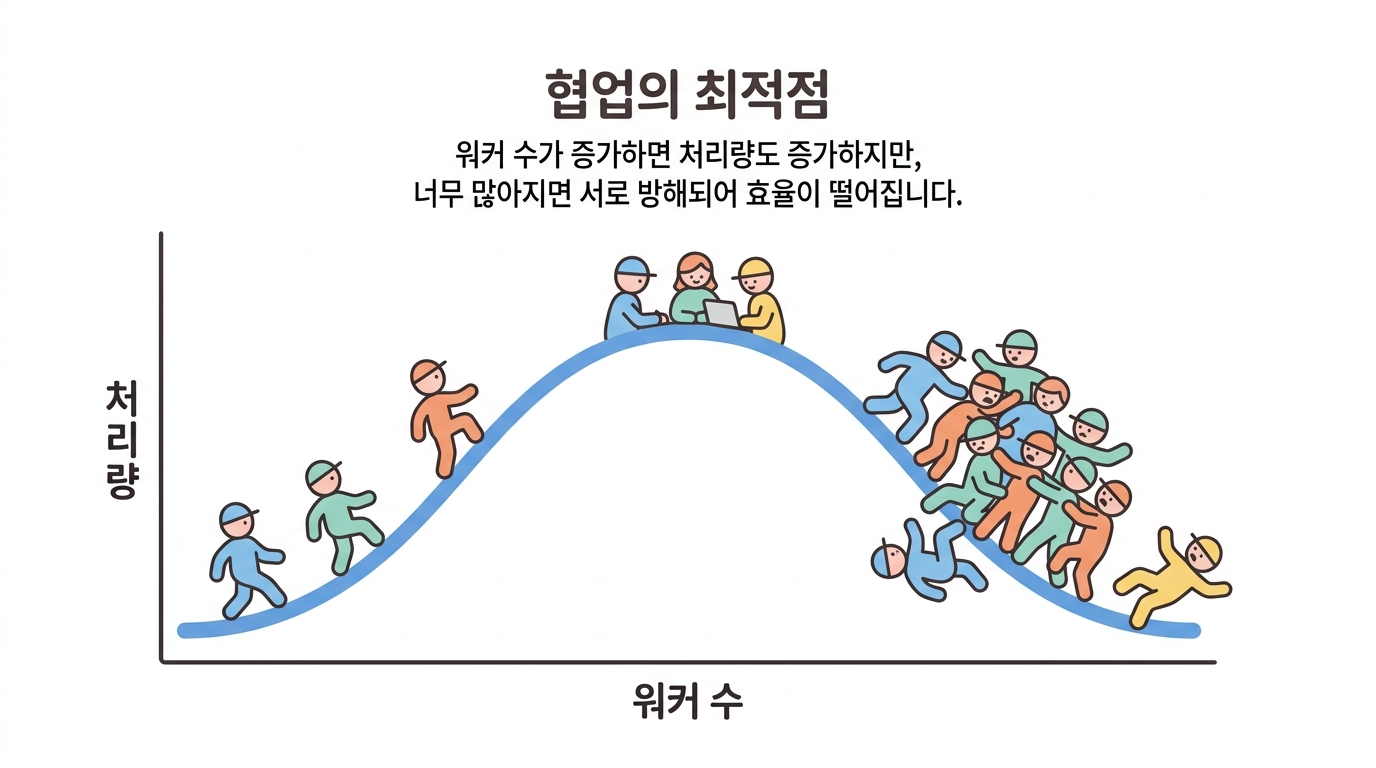
워커를 늘리면 생기는 두 가지 힘
이 둘이 만나는 지점이 최적입니다. 그리고 그 지점은 작업의 성격에 따라 완전히 다릅니다.
최적 워커 수는 '얼마나 기다리는 작업이냐'가 정합니다.
Python
브라우저에서 실행
문맥 교환 — 일꾼이 많아질수록 커지는 세금
CPU 하나에 프로세스가 여럿이면 커널이 번갈아 가며 시켜야 합니다. 바꿀 때마다 레지스터를 저장하고, 캐시가 밀려나고, TLB가 무효화돼요. 한 번에 1~10마이크로초씩 사라집니다.
평상시 값을 기억해 두세요. 나중에 비교 기준이 됩니다.
bash
브라우저에서 실행
cs 와 sy 가 함께 치솟는 걸 보세요. 이게 '너무 많다'의 신호입니다.
bash
브라우저에서 실행
클라우드의 함정 — 내 코어가 내 것이 아니다
클라우드 VM이나 컨테이너에서는 nproc이 12라고 나와도
실제로 12개를 다 쓸 수 있는 게 아닐 수 있습니다.
- cgroup 제한 — 컨테이너에 CPU 할당량(quota)이 걸려 있으면 그만큼만 씀
- 버스트 인스턴스(t 계열) — 크레딧이 떨어지면 성능이 20%로 떨어집니다
- 스틸 타임 —
top의%st. 같은 물리 서버의 다른 손님이 내 몫을 가져간 시간
물리 서버라 %st 는 0입니다. 클라우드에서는 확인해야 해요.
bash
브라우저에서 실행
워커 종류도 골라야 합니다
| 방식 | 동시성 | 언제 쓰나 |
|---|---|---|
| sync (기본) | 워커 수만큼 | CPU 위주. 단순하고 안전. 대기가 길면 낭비 |
| gthread | 워커 × 스레드 | DB·API 대기가 많을 때. 메모리 효율이 좋다 |
| gevent/async | 수천 | 대기가 압도적일 때. 코드가 그걸 지원해야 함 |
쇼핑몰 대부분은 DB를 기다리는 시간이 절반 이상입니다.
그래서 -w 4 --threads 4 처럼 스레드를 섞는 게
-w 16 보다 메모리를 4분의 1만 쓰면서 비슷한 동시성을 냅니다.
대기가 많은 워크로드에서는 스레드가 메모리를 아껴 줍니다.
Python
브라우저에서 실행
🤔 확인 문제
워커를 12개에서 24개로 늘렸더니 처리량이 오히려 줄고
%sy와 cs가 급증했습니다. 무엇이 문제인가요?해설
sy(커널 시간)와 cs(문맥 교환)가 함께 뛰는 건 커널이 프로세스를 바꿔 끼우느라 바쁘다는 신호입니다. 일꾼이 많아진 게 아니라 교대 비용이 커진 거예요. 되돌리는 게 답입니다.🤔 확인 문제
DB 조회를 기다리는 데 요청 시간의 70%를 쓰는 쇼핑몰입니다. 6코어 서버에서 어떤 설정이 가장 합리적일까요?
해설 기다리는 동안 CPU는 놉니다. 그 틈에 다른 요청을 처리하게 해야 코어가 쉬지 않아요. 다만 메모리 상한(16강)과 문맥 교환 비용이 있으니 100개는 지나칩니다.
-w 4 --threads 4 같은 조합이 메모리 대비 효율이 좋습니다.