20강 / 20강
블랙프라이데이 — 어디가 먼저 터질까
20강 전부를 한 판에 쏟아붓는 실전
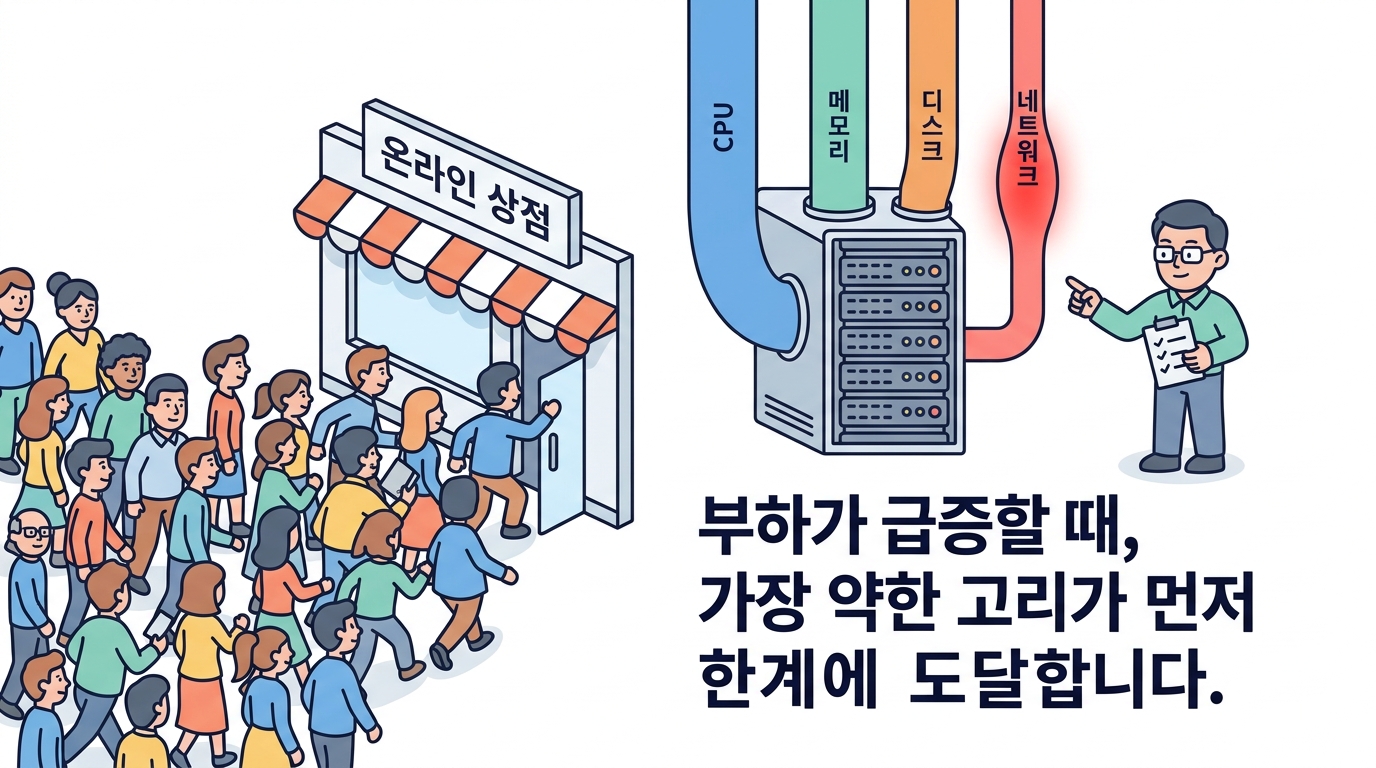
드디어 마지막 강입니다. 지금까지 배운 걸 전부 써서 진짜 상황을 다뤄 봅시다.
오늘 밤 자정에 블랙프라이데이 세일이 시작됩니다.
평소 초당 30건이던 요청이 초당 300건으로 뜁니다.
서버는 6코어 16GB NVMe 한 대. 여러분은 무엇을 준비해야 할까요?
① 먼저 한계를 계산합니다
"터질 것 같다"가 아니라 "초당 몇 건에서 터진다"를 알아야 합니다.
자원마다 한계를 따로 계산하면 병목이 보입니다.
Python
브라우저에서 실행
계산해 보면 네트워크 회선이 가장 먼저 막힙니다. 850KB짜리 페이지를 1Gbps로 뿌리면 초당 147건이 천장이거든요.
CPU를 아무리 늘려도 소용없습니다. 회선을 넓히거나, 보낼 양을 줄여야 해요.
② 대응책의 효과를 계산합니다
가장 싼 대응이 가장 효과가 큰 경우가 많습니다.
Python
브라우저에서 실행
③ 세일 당일 무슨 일이 벌어지나 — 직접 겪어 봅시다
평상시 상태를 먼저 기록해 둡니다.
bash
브라우저에서 실행
us 가 90%대로. load 가 코어 수를 넘어갑니다.
bash
브라우저에서 실행
메모리를 무리하게 쓰면 어떻게 되는지 봅니다.
bash
브라우저에서 실행
wa 가 치솟고 b(블록된 프로세스)가 생깁니다.
bash
브라우저에서 실행
④ 실전 체크리스트
세일 전날에 해 둘 일들입니다. 당일에는 이미 늦어요.
| 언제 | 할 일 | 왜 (몇 강) |
|---|---|---|
| 전날 | 평상시 지표를 기록해 둔다 | 비교 기준이 없으면 진단 불가 (15강) |
| 디스크 여유 20% 이상 확보 | SSD는 꽉 차면 느려진다 (12강) | |
| 이미지를 CDN으로, 압축 켜기 | 회선이 첫 병목 (13강) | |
| 로그 로테이션·백업을 세일 시간 밖으로 | 디스크를 뺏기지 않기 (18강) | |
| 워커 수를 부하 테스트로 정해 둔다 | 추측 금지 (17강) | |
| 당일 | vmstat 1 을 띄워 둔다 | si/so·wa·r 을 실시간 감시 (15강) |
| 느려지면 측정부터, 설정 변경은 그다음 | 오진이 가장 비싸다 (15강) | |
| 최악의 경우 대기열로 전환 | 죽는 것보다 느린 게 낫다 (19강) | |
| 다음 날 | 지표와 로그를 저장해 둔다 | 내년의 기준선이 된다 |
| 실제 병목이 어디였는지 기록 | 다음 투자를 정하는 근거 |
⑤ 마지막으로 — 20강을 한 장으로
느린 서버 앞에 앉았을 때, 이 순서로 생각하세요.
1. 무엇을 기다리는가?
   us 높음 → CPU가 계산 중        → 코드·코어      (5,10,11,17강)
   wa 높음 → 디스크를 기다림      → SSD·fsync·캐시 (7,12,18강)
   si/so   → 메모리 부족          → 증설·워커 감소 (9,16강)
   si 높음 → 패킷 폭주            → CDN·LB         (13강)
   전부 낮음 → 락·외부 API 대기   → 애플리케이션

2. 그 자원의 한계는 초당 몇 건인가?     (19,20강)
3. 가장 싼 대응부터 적용한다.           (CDN > 캐시 > 설정 > 하드웨어)
4. 다시 측정한다. 병목은 옮겨 다닌다.
이 네 줄이 컴퓨터 구조를 배운 이유입니다. 서버 안에서 무슨 일이 벌어지는지 알면, 어디에 돈과 시간을 쓸지 알 수 있습니다.
🤔 확인 문제
초당 300건 목표인데 계산 결과 CPU 한계 380건, 디스크 한계 2,500건, 회선 한계 147건이 나왔습니다. 무엇을 해야 할까요?
해설 가장 작은 숫자가 병목입니다. 회선이 147건에서 막히면 CPU가 380건을 감당할 수 있어도 소용없어요. 그리고 회선을 넓히는 것보다 CDN과 압축으로 페이지 무게를 줄이는 게 훨씬 쌉니다 — 850KB를 120KB로 줄이면 한계가 1,041건이 됩니다.
🤔 확인 문제
병목 하나를 해결했더니 이번엔 다른 곳이 느려졌습니다. 이건 실패인가요?
해설 체인의 가장 약한 고리를 튼튼하게 만들면 그다음으로 약한 고리가 드러납니다. 이게 정상이고, 목표 성능에 닿을 때까지 반복하는 게 튜닝이에요. 한꺼번에 여러 개를 바꾸면 무엇이 효과가 있었는지 알 수 없게 되니, 한 번에 하나씩 바꾸고 재는 것이 중요합니다.