기계어와 어셈블리 — 미니 CPU를 직접 몰다
명령어도 그냥 숫자다
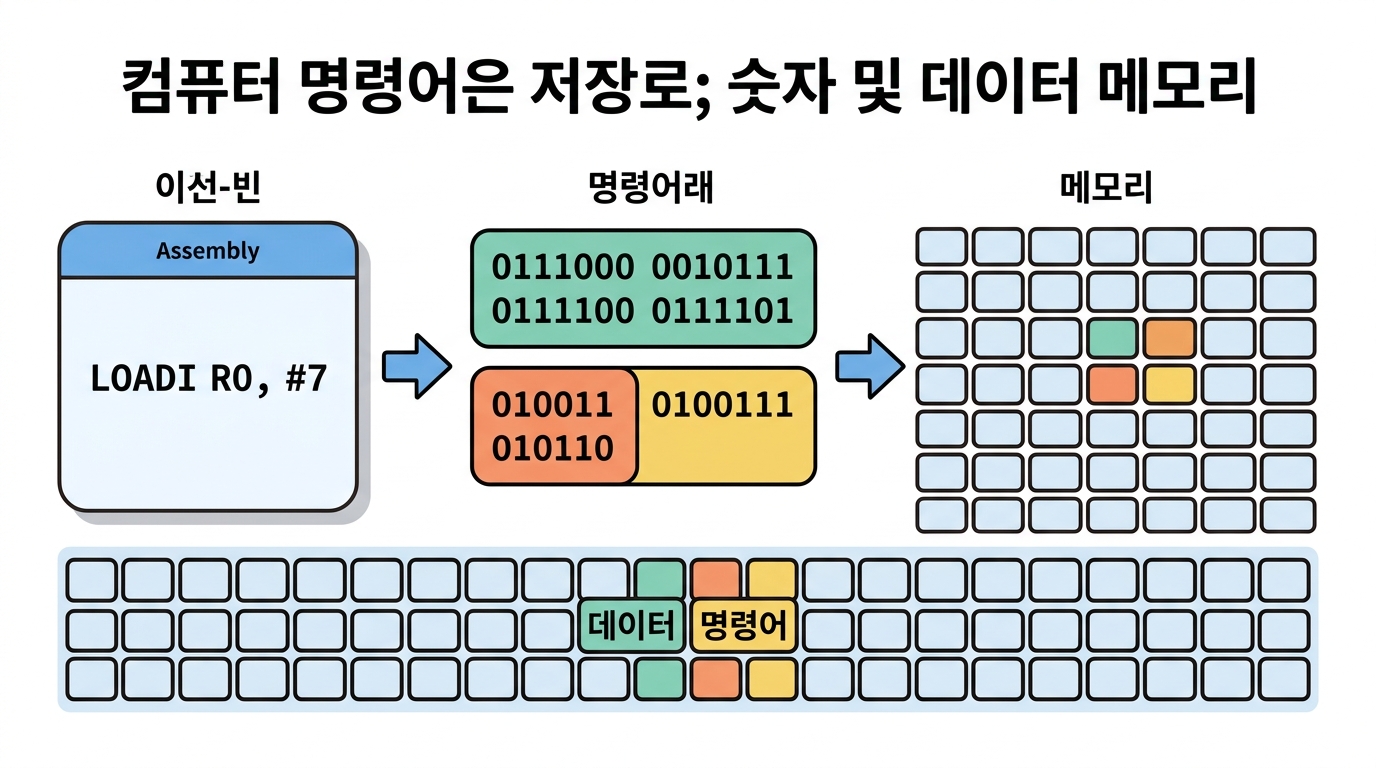 어셈블리 한 줄은 기계어 한두 워드가 됩니다. 그 워드도 결국 메모리에 든 숫자예요.
앞 강에서 CPU가 "명령을 꺼내 실행한다"고 했습니다.
그 명령이라는 게 실제로 어떻게 생겼을까요?
이번 강에서는 여러분에게 CPU 한 대를 통째로 드립니다.
아주 작지만 진짜와 같은 얼개예요 — 레지스터 4개, 메모리 256칸, 플래그 4개.
어셈블리를 쓰면 서버가 기계어로 번역해서 한 걸음씩 돌려 줍니다.
미니 CPU 명세
| 워드 | 16비트 (부호 있는 수로 -32768 ~ 32767) |
|---|
| 레지스터 | R0 R1 R2 R3 |
|---|
| 메모리 | 256워드 — 프로그램도 데이터도 같은 곳에 산다 |
|---|
| 스택 | 255번지에서 아래로 자란다 |
|---|
| 플래그 | Z(0인가) N(음수인가) C(자리올림) V(오버플로) |
|---|
가장 짧은 프로그램
아래 셀에서 ▶ 실행을 누르면 어셈블 결과와 실행 기록이 함께 나옵니다.
기계어 보기를 켜면 어셈블리 한 줄이 어떤 숫자가 되는지 볼 수 있어요.
5줄짜리 프로그램. 인출·해독·실행이 다섯 바퀴 돕니다.
메모리에 넣고 빼기 — 폰노이만 구조
이번엔 재고를 메모리에 두고 다뤄 봅시다.
프로그램 아래쪽 stock: .WORD 20 이 데이터 칸입니다.
명령어와 데이터가 같은 메모리에 나란히 삽니다.
메모리 지도를 보세요. stock 칸은 명령어 바로 뒤에 붙어 있습니다.
CPU 입장에서는 둘 다 그냥 숫자예요. 명령으로 읽으면 명령이고, 데이터로 읽으면 데이터입니다.
이게 폰노이만 구조의 힘이자 약점입니다. PC가 실수로 데이터 칸으로 흘러 들어가면
CPU는 데이터를 명령이라고 우기며 실행하려 들어요. 실제 보안 공격의 상당수가 이 틈을 노립니다.
반복 — 고급 언어의 for 문 속살
파이썬의 for i in range(1, 11) 은 CPU 수준에서는 이렇게 생겼습니다.
반복문 = 비교(CMP) + 조건 점프(JLE). 그게 전부입니다.
CMP는 값을 바꾸지 않습니다. 몰래 빼 보고 플래그만 남겨요.
그 플래그를 보고 JLE가 PC를 뒤로 되돌립니다.
즉 if 도 for 도 while 도 전부 "플래그 보고 PC 옮기기"입니다.
10강에서 볼 분기 예측이 왜 성능에 그렇게 중요한지가 여기서 보이기 시작해요 —
CPU는 JLE가 뛸지 말지를 미리 찍어야 하거든요.
배열 훑기 — 장바구니 합계
배열이란 결국 연속된 메모리 칸입니다.
"다음 상품"으로 가는 건 주소를 INC 하는 것뿐이에요.
배열 = 주소 + 순서. 이래서 배열이 그렇게 빠릅니다.
함수 호출과 스택
함수를 부르면 돌아올 주소를 어딘가 적어 둬야 합니다. 그 어딘가가 스택이에요.
CALL은 돌아올 주소를 스택에 넣고, RET은 그걸 꺼냅니다.
가장 놀라운 것 — 프로그램이 자기를 고친다
명령어도 그냥 메모리에 든 숫자라면, 프로그램이 자기 명령어를 덮어쓸 수도 있지 않을까요?
됩니다. 아래를 실행해 보세요. LOADI R0, #1 의 '1'이 실행 도중에 99로 바뀝니다.
출력이 1 다음에 99가 나옵니다. 프로그램이 바뀐 거예요.
CPU가 어떤 명령어를 알아듣는지 봅니다. aes 가 있으면 HTTPS가 빨라집니다.
🤔 확인 문제
CMPI R1, #10 명령이 하는 일은?
해설 CMP는 몰래 빼 보고 결과는 버립니다. 남기는 건 Z·N·C·V 플래그뿐이에요. 그 다음 줄의 조건 점프가 그 플래그를 읽고 뛸지 말지 정합니다. 두 명령이 한 쌍으로 움직이는 거죠.
🤔 확인 문제
어셈블리에서 LOADI R0, #7 이 메모리 2워드를 쓰고 ADD R0, R1 이 1워드만 쓰는 이유는?
해설 명령어 워드에는 '무슨 연산 + 어느 레지스터'만 들어갑니다. 즉시값이나 메모리 주소처럼 16비트짜리 큰 값은 뒤에 한 칸을 더 붙여야 해요. 그래서 레지스터끼리 하는 연산이 코드도 작고 인출도 빠릅니다.