17강 / 20강
모니터링 — 지금 우리 서버는 괜찮은가
손님이 신고하기 전에 먼저 아는 법
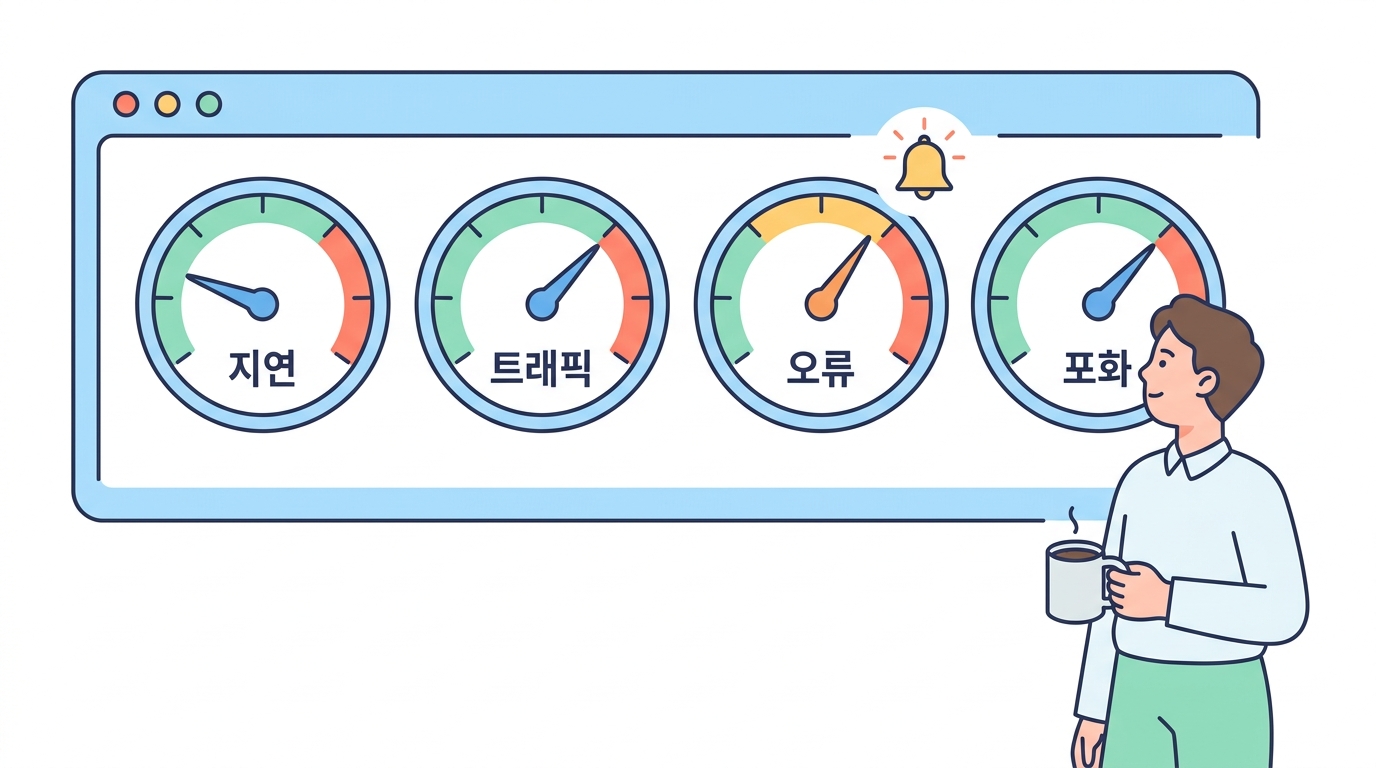
3부입니다. 이제 서버는 돌아갑니다. 문제는 계속 돌아가게 하는 것이죠.
운영자의 실력은 장애를 얼마나 잘 고치느냐보다 장애를 얼마나 먼저 아느냐 로 갈립니다. 손님 전화를 받고 아는 것과, 알림을 받고 이미 고치는 중인 것은 완전히 다른 일이에요.
매일 아침 30초 점검
거창한 모니터링 시스템을 붙이기 전에, 명령 네 줄이면 서버 상태의 90%를 알 수 있습니다.
이 네 줄을 매일 아침 습관처럼 돌려 보세요.
🖥️ 내 가상 서버
브라우저 안에서 실행 (계산용)
무엇을 볼 것인가 — 네 가지 황금 신호
| 지표 | 보는 법 | 나쁠 때의 뜻 |
|---|---|---|
| 지연 latency | 응답 시간(TTFB) | 느려짐 = 손님 이탈. 평균보다 상위 5%를 보세요 |
| 트래픽 traffic | 초당 요청 수 · 대역폭 | 급증 = 이벤트거나 공격 |
| 오류 errors | 5xx 비율 | 0.1%만 넘어도 즉시 봐야 합니다 |
| 포화 saturation | CPU·메모리·연결 수 | 한계에 가까움 = 곧 터짐 |
이 네 가지는 구글 SRE 팀이 정리한 것으로, 어떤 서비스든 이 넷만 보면 지금 건강한지를 판단할 수 있습니다.
평균의 함정
"평균 응답 시간 80ms" 라는 보고를 받았습니다. 좋아 보이죠? 그런데 손님 100명 중 95명은 20ms, 5명은 1.2초였을 수도 있습니다. 평균은 여전히 80ms예요.
그 5명이 하필 결제 페이지에서 기다린 손님이라면 매출이 날아갑니다. 그래서 운영자는 평균이 아니라 p95 · p99(상위 5%, 1%의 응답 시간)를 봅니다.
왜 평균을 믿으면 안 되는지 숫자로 확인해 보세요.
Python
브라우저 안에서 실행 (계산용)
로그에서 바로 뽑아 쓰는 한 줄들
모니터링 도구가 없어도 awk 한 줄이면 많은 것을 알 수 있습니다.
| 알고 싶은 것 | 명령 |
|---|---|
| 상태 코드별 개수 | awk '{print $9}' access.log | sort | uniq -c | sort -rn |
| 가장 많이 온 IP | awk '{print $1}' access.log | sort | uniq -c | sort -rn | head |
| 가장 많이 요청된 주소 | awk '{print $7}' access.log | sort | uniq -c | sort -rn | head |
| 지금 이 순간의 5xx | tail -f access.log | grep ' 5[0-9][0-9] ' |
위 명령들이 무엇을 세는지 로그 형식과 대조해 보세요.
🖥️ 내 가상 서버
브라우저 안에서 실행 (계산용)
바깥에서 지켜보는 눈이 필요합니다
서버 안에서 돌리는 모니터링에는 치명적인 맹점이 있습니다. 서버가 통째로 죽으면 알림도 같이 죽습니다.
그래서 외부 업타임 감시를 하나 붙여 두세요.
1분마다 바깥에서 https://mallshop.kr 을 두드려 보고
응답이 없으면 문자를 보내 주는 서비스들이 있습니다(무료도 많습니다).
인증서 만료일 감시도 함께 켜 두면 13강의 사고를 막을 수 있어요.
🤔 확인 문제
평균 응답 시간은 80ms인데 손님들이 '가끔 엄청 느리다' 고 합니다. 무엇을 봐야 할까요?
해설 평균은 소수의 아주 느린 요청을 감춥니다. 상위 5%(p95)를 보면 '20명 중 1명이 1.2초를 기다린다' 는 사실이 드러나요.
🤔 확인 문제
서버 안에만 모니터링을 둔 경우의 가장 큰 문제는?
해설 자기 자신을 감시하는 시스템은 자기가 죽는 것은 못 알립니다. 바깥에서 두드려 보는 외부 감시를 반드시 하나 붙여 두세요.